
- IA
- Claude
- Agents IA
- Anthropic
Claude Fable 5.2 est sorti : faut-il changer le modèle de vos agents IA ?
Claude Fable 5.2 est sorti le 9 novembre 2026 : 20% moins cher, jusqu'à 30% plus rapide. Prix, données, limites et quatre gestes avant de migrer vos agents IA.
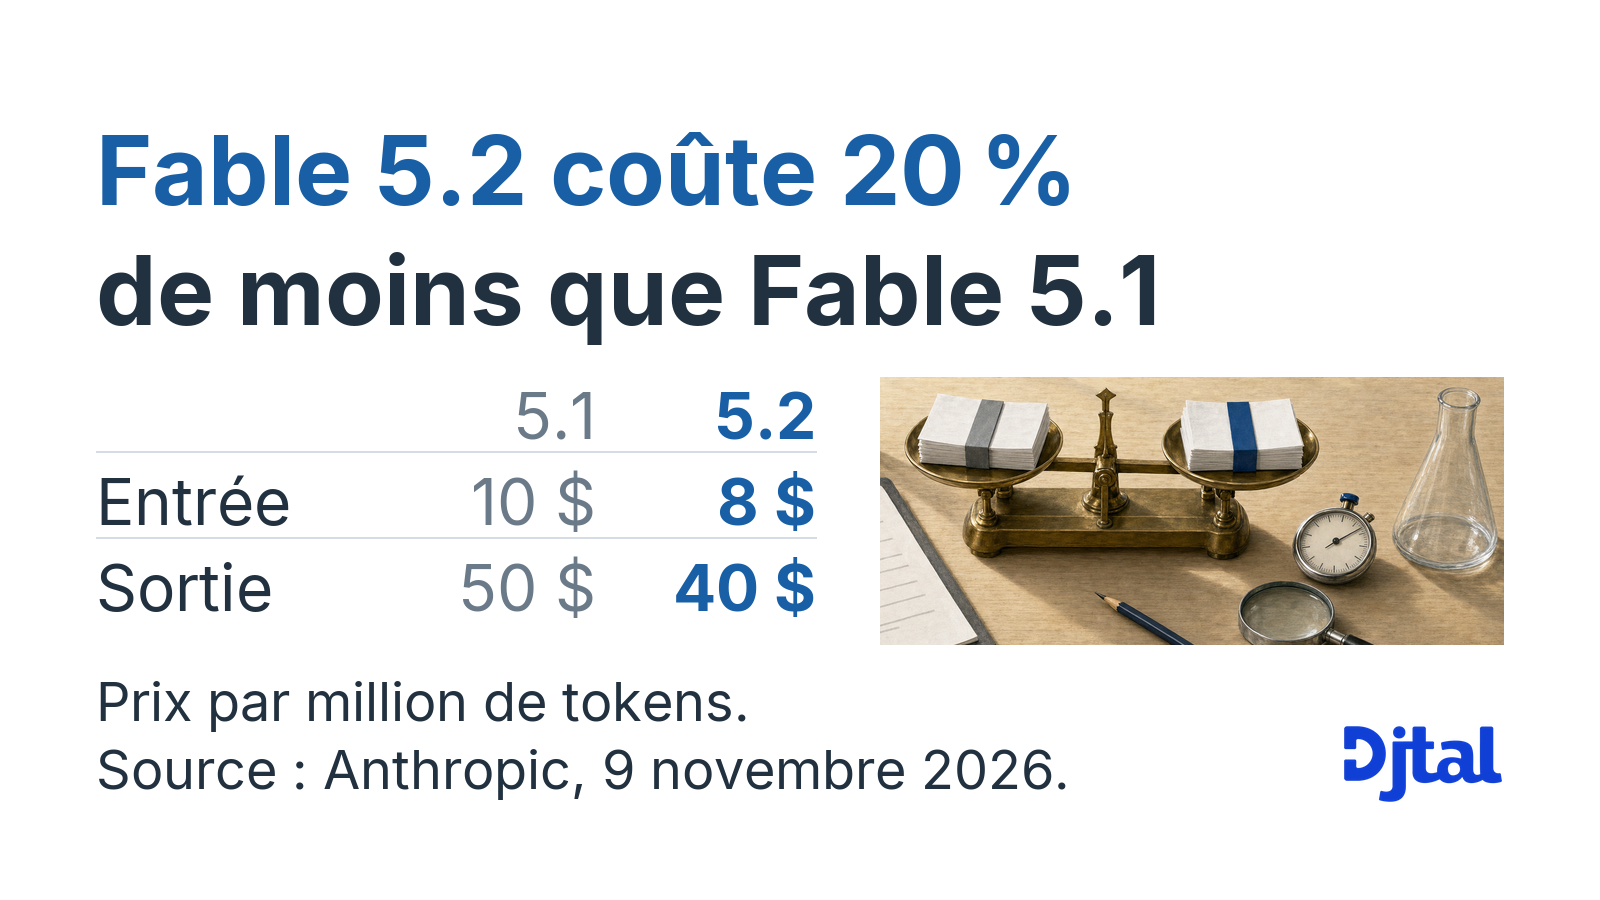
Anthropic a publié Claude Fable 5.2 le lundi 9 novembre 2026. Le modèle coûte 20% de moins que Fable 5.1 : 8 dollars par million de tokens en entrée, 40 en sortie. L’éditeur annonce des réponses jusqu’à 30% plus rapides. Pour une entreprise qui exploite des agents IA, trois sujets pèsent plus lourd que la remise. Ce sont le choix du modèle pour chaque tâche, la conservation des données et la manière de changer.
Qu’est-ce qui change avec Claude Fable 5.2 ?
Les tarifs baissent d’un cinquième sur toute la grille.
| Par million de tokens | Fable 5.1 | Fable 5.2 |
|---|---|---|
| Entrée | 10 $ | 8 $ |
| Sortie | 50 $ | 40 $ |
| Lecture de cache | 0,25 $ | 0,20 $ |
Un mode rapide en option accélère la sortie jusqu’à 2,5 fois, au double du tarif : 16 et 80 dollars. La fenêtre de contexte atteint 1 million de tokens.
Fable 5.2 a un jumeau, Mythos 5.2. C’est le même modèle, au même prix. Fable 5.2 est ouvert à tous et bloque la plupart des tâches de cybersécurité et de biologie. Mythos 5.2 est réservé aux organisations vérifiées par Anthropic dans ces deux domaines.
Le modèle est disponible dans les abonnements Pro, Max, Ultra, Team et Enterprise, par l’API d’Anthropic, chez Amazon Web Services, Google Cloud et Microsoft Foundry. Anthropic s’engage à le maintenir au moins jusqu’au 9 novembre 2027.
Que valent les chiffres publiés par Anthropic ?
Anthropic publie ses propres mesures. Le tableau en reprend cinq, proches du travail d’une entreprise.
| Mesure | Ce qu’elle évalue | Fable 5.1 | Fable 5.2 | Opus 5.5 |
|---|---|---|---|---|
| AutomationBench | processus métier | 31,4% | 51,4% | 42,5% |
| Remote Labor Index | travail de connaissance | 17,9% | 41,3% | 21,3% |
| FrontierSWE v2 | développement logiciel | 56,3% | 69,9% | 62,3% |
| OSWorld 2.1 | usage d’un ordinateur | 83,5% | 89,3% | 87,2% |
| Humanity’s Last Exam (avec outils) | connaissance et raisonnement | 65,6% | 74,2% | 67,7% |
Le plus gros écart porte sur les processus métier, avec vingt points de plus. Sur le travail de connaissance, le score fait plus que doubler.
Je lis ces chiffres avec trois réserves. Ils viennent de l’éditeur, le plus souvent au niveau d’effort le plus élevé. Sur AutomationBench, son propre tableau place Gemini 4 Carbon, de Google, devant Fable 5.2 avec 53,9%. C’est le seul test publié où un concurrent passe devant. Les organismes externes qui ont testé le modèle avant sa sortie, dont l’AI Security Institute britannique et METR, n’ont pas relu l’annonce.
Anthropic raconte aussi un prototype de système d’exploitation écrit en huit jours par plus de mille sous-agents, puis le dernier théorème de Fermat formalisé en trente heures. Ce sont des récits de l’éditeur. Aucune vérification indépendante n’est publiée à ce jour.
Fable 5.2 ou Opus 5.5 : quel modèle pour quel travail ?
Pour le travail de tous les jours, Anthropic conseille un autre de ses modèles, Claude Opus 5.5. Il coûte 4 dollars en entrée et 20 en sortie, la moitié de Fable 5.2. Fable 5.2 est fait pour les travaux les plus difficiles, ceux où Opus 5.5 ne suffit plus.
Le tarif affiché renseigne mal sur le coût d’un travail terminé. Sur le test de programmation FrontierCode 2.0, publié par Anthropic, Fable 5.2 obtient 45,3% et Opus 5.5 45,5%. Les deux résultats se valent. Fable 5.2 y arrive pour environ la moitié du coût, avec un tarif deux fois plus élevé. Opus 5.5 a besoin de son réglage de réflexion le plus poussé pour atteindre ce score.
Ce réglage s’appelle le niveau d’effort. Il fixe le temps de réflexion du modèle avant de répondre, sur cinq niveaux, de « low » à « max ». Il pèse autant sur la facture que le choix du modèle. La documentation conseille de partir de « high » et de refaire ses essais à chaque changement de modèle : un même niveau correspond à un temps de réflexion différent d’un modèle à l’autre.
Le bon calcul se fait sur vos propres travaux, livrable par livrable.
Que deviennent vos données avec Fable 5.2 ?
Avec Fable 5.2, Anthropic conserve vos échanges pendant 30 jours pour ses contrôles de sécurité. Certaines entreprises ont un contrat sans aucune conservation (« zero data retention »). Avec ce modèle, cette option demande l’accord exprès d’Anthropic.
Anthropic prépare une solution, Enterprise Frontier Safeguards : les contrôles de sécurité tournent alors sur des données gardées chez le client. Elle est en test privé chez trois entreprises, Bridgewater, Salesforce et Stripe.
Si vos agents traitent des dossiers de clients, vérifiez ce point avant de changer.
Les protections du modèle ont un second effet. Quand Fable 5.2 refuse une demande de cybersécurité, un modèle plus ancien, Opus 4.8, répond à sa place. Pour la biologie, c’est Opus 5. Anthropic annonce environ 55% de refus en moins qu’avec Fable 5.1. Une équipe informatique qui fait de l’audit de sécurité le verra dans son travail.
Quatre gestes avant de changer de modèle
- Relire les instructions de vos agents. Elles ont été écrites pour l’ancien modèle. Anthropic prévient que certaines coûtent plus cher avec le nouveau ou restent sans effet. Fable 5.2 applique les règles à la lettre. Un agent chargé de consignes de prudence demandera plus souvent une validation dont vous n’avez pas besoin.
- Refaire le réglage d’effort. Partir de « high », puis essayer le niveau du dessous et celui du dessus sur vos travaux réels.
- Faire vérifier vos développements sur mesure. Quatre changements techniques concernent les équipes qui ont programmé elles-mêmes la liaison avec le modèle. Le principal : un programme qui modifie l’historique d’une conversation en cours reçoit désormais une erreur. Sur ce point, rien ne change pour les agents qui passent par Claude Code, claude.ai ou le SDK d’agents d’Anthropic.
- Comparer à l’aveugle, sur vos propres travaux. Même travail, même dossier, deux modèles, des lecteurs qui ignorent lequel a produit quoi.
L’expérience m’a montré qu’adopter un modèle le jour de sa sortie est parfois contre-productif. Nous avons donc lancé des tests intensifs en interne sur des travaux réels. Je publierai les recommandations d’ici une semaine.
Questions fréquentes
Combien coûte Claude Fable 5.2 ? 8 dollars par million de tokens en entrée et 40 en sortie, contre 10 et 50 pour Fable 5.1. Les lectures de cache coûtent 20 cents, le traitement par lots est à moitié prix, le mode rapide double le tarif. Le modèle est aussi inclus dans les abonnements Pro, Max, Ultra, Team et Enterprise.
Quelle différence entre Fable 5.2 et Mythos 5.2 ? C’est le même modèle, au même prix. Fable 5.2 est ouvert à tous, avec des garde-fous en cybersécurité et en biologie. Mythos 5.2 est réservé aux organisations admises dans les programmes de vérification d’Anthropic.
Faut-il passer à Claude Fable 5.2 tout de suite ? Pour un usage de Fable 5.1 par l’API, la baisse de 20% s’applique dès le changement d’identifiant de modèle. Pour des agents en production, mieux vaut un essai à l’aveugle sur un seul agent avant de changer les autres. Pour le travail courant, Anthropic recommande Opus 5.5, deux fois moins cher.
Sources
- Anthropic, « Introducing Claude Fable 5.2 and Claude Mythos 5.2 », 9 novembre 2026 : mesures, prix, garde-fous, conservation des données, réserves de l’éditeur.
- Anthropic, documentation « Claude Fable 5.2 » et « What’s new in Claude Fable 5.2 » : tarifs, fenêtre de contexte, conservation de 30 jours, changements techniques à vérifier, date de retrait.
- Anthropic, documentation « Prompting Claude Fable 5.2 » : niveaux d’effort, consignes héritées d’un modèle précédent.
- AFP, 10 novembre 2026 : même modèle sous-jacent, accès à Mythos 5.2.
- TechCrunch, 9 novembre 2026 et The Next Web, 9 novembre 2026 : contexte de la sortie, démonstrations non vérifiées par un tiers.
Vous voulez savoir quel modèle affecter à quelle tâche et qui pourrait le prouver ? L’audit stratégique IA de Djtal établit la configuration, les preuves et les réglages de vos agents. Échangeons.
Un sujet à creuser pour votre entreprise ?
Échangeons 30 minutes pour comprendre votre contexte et identifier où l'IA peut vous servir.
Parler avec un de nos experts