
- IA
- Claude
- Agents IA
- Customer Zero
- Anthropic
Changer de modèle d'IA en une nuit : Claude Fable 5.1 en production
Claude Fable 5.1 est sorti le 1er septembre 2026. Djtal a basculé ses 14 dépôts d'agents IA la nuit même : méthode en cinq gestes, réglage d'effort, prix.
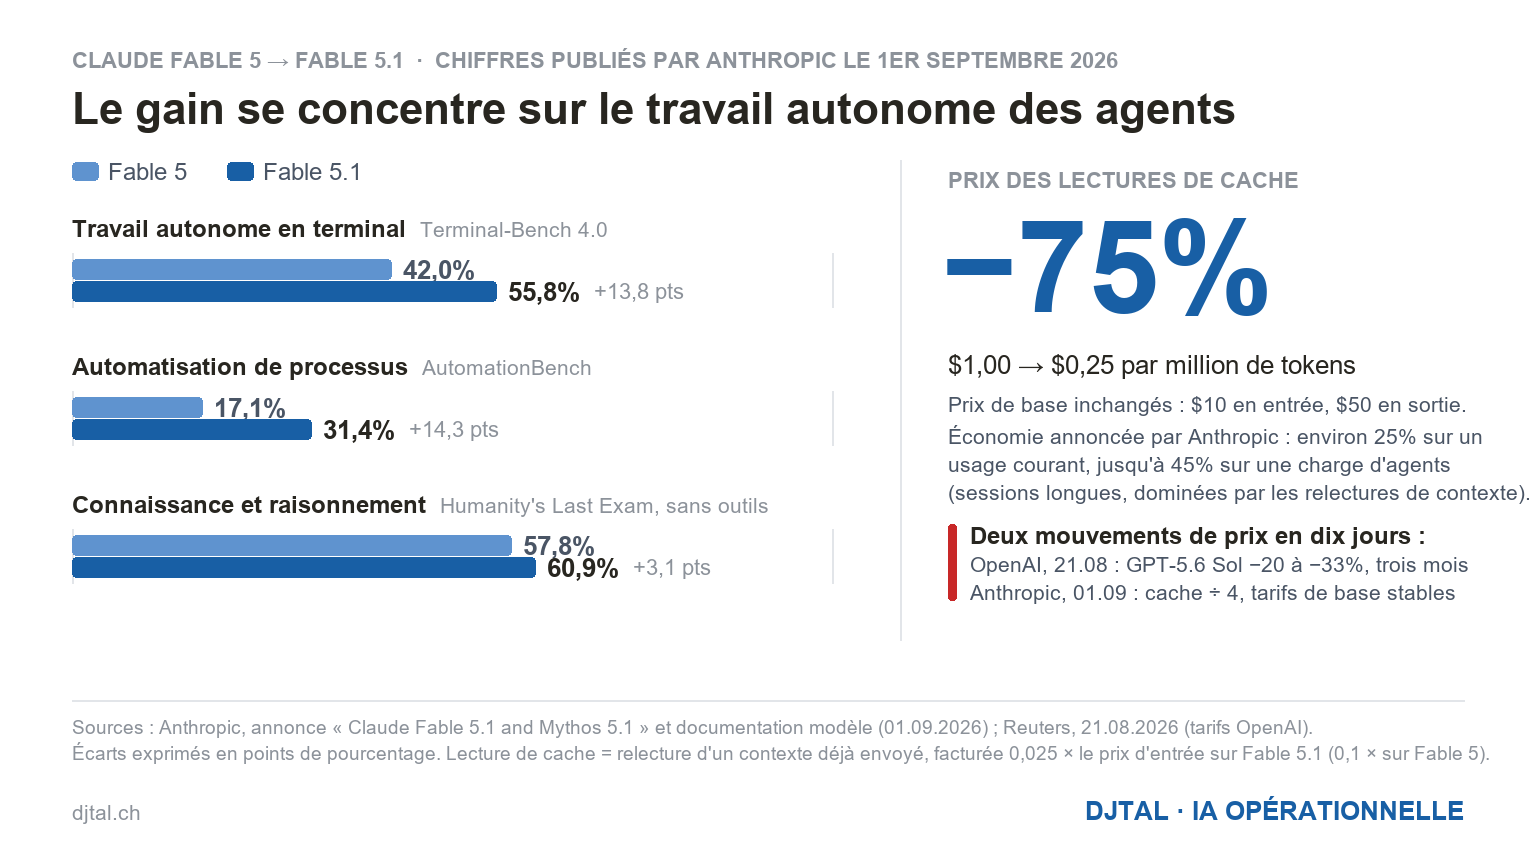
Claude Fable 5.1 (Anthropic) est sorti le 1er septembre 2026 : tarifs de base identiques à Fable 5, lectures de cache divisées par quatre, gains concentrés sur le travail long et autonome des agents. Djtal a basculé ses quatorze dépôts d’agents IA la nuit même, en moins d’une heure, parce que le modèle de chaque agent est déclaré dans une configuration versionnée et vérifiée au démarrage. Le travail sérieux commence après la bascule : refaire les réglages d’effort et mesurer.
Ce que Claude Fable 5.1 change, d’après les chiffres publiés
Anthropic publie ses propres benchmarks. Les voici tels quels, avec ce que chacun mesure.
| Benchmark | Ce qu’il mesure | Fable 5 | Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | travail autonome en terminal | 42,0% | 55,8% |
| AutomationBench | automatisation de processus | 17,1% | 31,4% |
| OSWorld 2.0 (strict) | usage d’un ordinateur | 36,1% | 41,7% |
| GDPval-AA v2 | travail de bureau (score Elo) | 1723 | 1853 |
| Humanity’s Last Exam (sans outils) | connaissance et raisonnement | 57,8% | 60,9% |
Les deux plus gros sauts, près de quatorze points chacun, portent sur le travail long en terminal et sur l’automatisation de processus : le quotidien d’agents en production. Sur le travail de bureau, le gain existe et reste modéré. Sur la connaissance pure, il est marginal.
Côté prix, l’entrée reste à 10 dollars et la sortie à 50 dollars par million de tokens. Les lectures de cache, c’est-à-dire la relecture d’un contexte déjà envoyé, passent de 1 dollar à 25 cents par million : 0,025 fois le prix d’entrée, contre 0,1 sur les autres modèles Claude. Anthropic annonce environ 25% d’économie sur un usage courant et jusqu’à 45% sur une charge d’agents, parce qu’une longue session relit son contexte à chaque étape.
Deux points encore. Les garde-fous de cybersécurité interviennent environ 60% moins souvent par session dans Claude Code, d’après l’éditeur. La prose est donnée comme meilleure, et la documentation avertit qu’elle est parfois plus dense, phrases plus longues et paragraphes plus rares. Nous relisons nos textes avec cette consigne depuis mardi.
Comment Djtal a changé de modèle en une nuit
Nuit du mardi 1er au mercredi 2 septembre, 00h40. Je change de modèle dans ma session de travail, puis je demande à Sofia, notre agente d’orchestration, de propager. À 01h30, quatorze dépôts tournent sur Fable 5.1 : les sept agents de Djtal, le kit de déploiement et son modèle d’instance, les six instances installées chez des clients, nos agents privés. Les cinq gestes, dans l’ordre.
- Une configuration versionnée, lue au démarrage. Le modèle et le niveau d’effort de chaque agent sont déclarés dans des fichiers suivis par git ; le lanceur les lit à chaque ouverture de session. Sans elle, le nom du modèle est copié un peu partout et le changement devient un projet.
- Une preuve d’acceptation avant toute propagation. Sofia a lancé un appel réel avec la nouvelle clé de modèle et attendu que l’outil l’accepte.
- La propagation aux endroits habituels. Quinze fichiers de configuration modifiés, kit de déploiement et modèle d’instance compris, pour que les prochaines instances naissent déjà sur la bonne version.
- La vérification au réel. Un agent relancé, le modèle constaté dans la session. « Ça devrait marcher » a été remplacé par « ça tourne ».
- La trace. Deux commits horodatés à 00h45, relisibles fichier par fichier. Si quelque chose casse, on sait quoi relire et quoi annuler.
Nous avions fait le même chemin en juin, dans les deux sens : bascule sur Fable 5 le 11 juin, puis retour sur le modèle précédent le 13 juin quand l’accès a été suspendu, sans perdre un chantier. La méthode a servi deux fois avant de servir une troisième.
L’effort : le réglage qui pilote coût et qualité
La documentation d’Anthropic est claire sur ce point, et rarement lue : « l’effort est le premier levier pour arbitrer entre intelligence, latence et coût », et il faut « refaire le balayage même si vous l’aviez fait sur Fable 5 : les noms de niveau ne correspondent pas à la même quantité de réflexion d’un modèle à l’autre » (traduit de l’anglais). Cinq niveaux existent, de « low » à « max » ; « high » est le point de départ recommandé ; « xhigh » vise le travail agentique de longue haleine, au-delà de trente minutes. Anthropic ajoute que l’écart avec Fable 5 est le plus large aux niveaux élevés, et qu’à effort moyen, Fable 5.1 égale à peu près Fable 5 pour moins cher.
Notre règle, décidée dans la foulée de la bascule : effort élevé par défaut pour tous les agents, cran supérieur pour les six qui tiennent des sessions longues ou produisent des pièces à enjeu. Premier test à l’aveugle la même nuit, sur une note d’arbitrage de 350 mots rédigée deux fois avec le même contexte : la version au cran supérieur a pris 99 secondes contre 41, les deux notes convergeaient sur la même recommandation, et c’est la première que j’ai préférée sans savoir laquelle était laquelle. Un seul essai. L’effet réel de Fable 5.1 sur la qualité de nos livrables rédigés reste à mesurer, et nous le dirons quand il le sera.
Deux mouvements de prix en dix jours
Le 21 août, OpenAI a baissé les tarifs développeurs de GPT-5.6 Sol pour trois mois : l’entrée de 5 à 4 dollars par million de tokens, la sortie de 30 à 20 dollars, sur l’API, les crédits Codex et ChatGPT Work, abonnements inchangés (Reuters). Le 1er septembre, Anthropic a gardé ses tarifs de base et divisé par quatre ses lectures de cache.
Pour une entreprise qui exploite des agents, trois conséquences.
- Le prix catalogue par token dit peu de chose du coût d’une tâche. Le niveau d’effort, la part de contexte relue et le nombre de reprises pèsent davantage. La seule comparaison utile se fait en coût par livrable, mesurée sur vos propres tâches.
- Une promotion de trois mois est une fenêtre. On en profite pour comparer ; on garde son architecture.
- Ces mouvements se suivent à une condition. Que le changement de modèle soit un geste de configuration, prouvé au démarrage, et tienne en une nuit.
Questions fréquentes
Faut-il passer à Claude Fable 5.1 tout de suite ? Si vos agents font du travail long et autonome, les chiffres publiés montrent un gain net, à effort élevé. La condition préalable est de pouvoir changer de modèle en un geste et de remesurer l’effort ensuite ; si ce geste vous prend des semaines, commencez par là.
Qu’est-ce que le réglage d’effort d’un modèle Claude ? Un paramètre en cinq niveaux, de « low » à « max », qui règle la quantité de réflexion et de tokens que le modèle dépense pour répondre. « High » est le défaut recommandé, « xhigh » sert au travail agentique de longue durée. Anthropic recommande de refaire ses mesures à chaque changement de modèle, parce qu’un même nom de niveau change de sens d’un modèle à l’autre.
GPT-5.6 Sol est-il devenu moins cher que Claude Fable 5.1 ? Au tarif catalogue, oui : 4 et 20 dollars en promotion contre 10 et 50. Mais le coût d’une tâche dépend de l’effort, du cache (25 cents par million de tokens relus sur Fable 5.1) et du nombre de reprises. La comparaison qui compte se mesure en coût par livrable, sur vos tâches, et la promotion d’OpenAI court jusqu’en novembre 2026.
Sources
- Anthropic, « Claude Fable 5.1 and Mythos 5.1 », 1er septembre 2026 : benchmarks, prix, garde-fous.
- Anthropic, documentation « What’s new in Claude Fable 5.1 » : tarifs, lectures de cache à 0,025 fois le prix d’entrée.
- Anthropic, documentation « Prompting Claude Fable 5.1 » et « Effort » : niveaux d’effort, recommandation de refaire le balayage, densité de la prose.
- Reuters, 21 août 2026, repris par Boursorama : baisse des tarifs développeurs de GPT-5.6 Sol.
- Djtal, journal git du 2 septembre 2026, 00h45 : commits de bascule du monorepo et du kit de déploiement.
Vous voulez savoir en combien de temps votre organisation changerait de modèle, et qui pourrait le prouver ? L’audit stratégique IA de Djtal établit la configuration, les preuves et les réglages de vos agents. Échangeons.
Un sujet à creuser pour votre entreprise ?
Échangeons 30 minutes pour comprendre votre contexte et identifier où l'IA peut vous servir.
Parler avec un de nos experts