
- IA
- Agents IA
- Claude
- Architecture
- Anthropic
Sous-agents IA : déléguer entre modèles sans perdre en qualité
Répartir le travail d'un agent IA entre plusieurs modèles : le schéma orchestrateur et sous-agents, l'apport de la gamme Claude 5.5 et trois réglages clés.
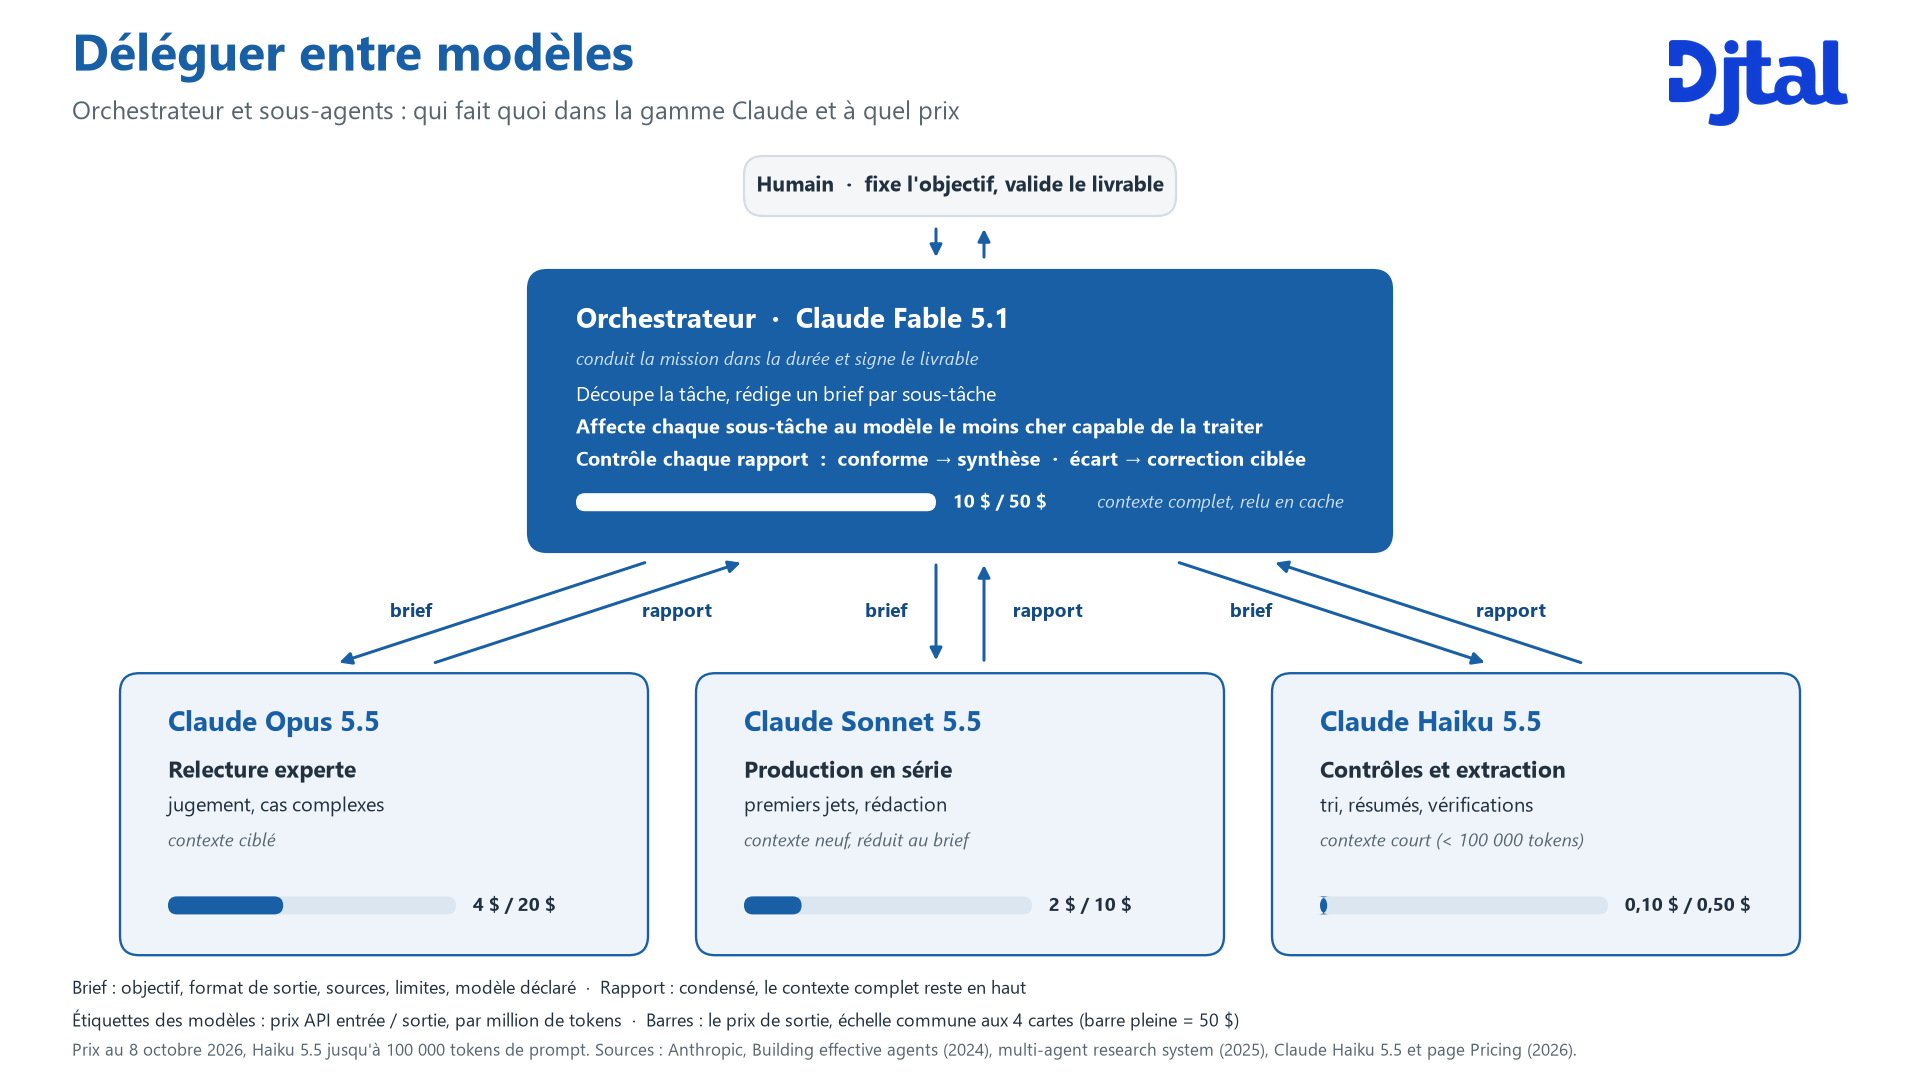
Un agent IA qui délègue peut confier chaque sous-tâche à un modèle différent. Un orchestrateur, sur un modèle fort, découpe le travail, rédige des briefs, puis contrôle et assemble les rapports. Des sous-agents, sur des modèles plus petits, traitent les tâches au périmètre précis. Depuis la sortie de Claude Haiku 5.5 le 7 octobre 2026, l’étage le plus bas de la gamme coûte cent fois moins cher en sortie que le haut de gamme. Son score sur des tâches professionnelles réelles a plus que doublé. Trois réglages, détaillés plus bas, décident de la rentabilité du montage.
Comment fonctionne la délégation entre modèles ?
Anthropic décrit ce schéma sous le nom d’orchestrateur et exécutants (orchestrator-workers). Un modèle central découpe la tâche, la délègue à d’autres modèles et combine leurs résultats. Une variante plus simple, le routage, classe chaque demande et l’envoie au modèle adapté : les questions courantes vers un petit modèle, les cas difficiles vers un modèle plus capable.
Chaque échange suit le même aller-retour.
- Le brief descend. Anthropic en fixe le contenu minimal à partir de son propre système de recherche : un objectif, un format de sortie, les outils et sources à utiliser, des limites claires. Avec un brief flou, les sous-agents refont les mêmes recherches et laissent des trous.
- Le sous-agent part d’un contexte neuf. Il ignore la conversation de l’orchestrateur et reçoit seulement ce que le brief lui transmet.
- Le rapport remonte, condensé. L’orchestrateur reçoit l’essentiel et conserve seul le contexte complet.
- L’orchestrateur contrôle. Il évalue chaque rapport, renvoie une correction ciblée quand un résultat s’écarte du brief, puis rédige la synthèse.
Comment garantir le niveau de qualité ?
La garantie repose sur deux gardes structurelles. À l’aller, le brief fixe le périmètre : objectif, format, sources, limites. Au retour, le contrôle précède la signature. Le modèle qui signe le livrable relit ce que les sous-agents produisent, la boucle qu’Anthropic appelle évaluateur et optimiseur, où un modèle produit et un autre évalue. Le niveau de qualité dépend de cette structure, bien plus que du talent du petit modèle.
La tâche déléguée reste à la portée du modèle qui la reçoit. Anthropic positionne Haiku 5.5 sur le travail au périmètre étroit : résumés, compactage de contexte, classification, requêtes en base de données, tâches de sous-agent. Selon l’éditeur, il s’associe bien à Opus 5.5 et Sonnet 5.5 comme sous-agent sur le travail de développement. La limite est donnée aussi. Sur le travail agentique complexe, Sonnet 5.5 et Opus 5.5 restent meilleurs. En travail autonome dans un terminal, Haiku 5.5 obtient 39,2% quand Sonnet 5.5 atteint 70,6%. Déléguer une tâche au petit modèle suppose donc qu’elle soit à sa mesure.
La combinaison peut dépasser le modèle seul. En juin 2025, Anthropic a mesuré son système de recherche : un orchestrateur Opus 4 entouré de sous-agents Sonnet 4 a dépassé Opus 4 seul de 90,2% sur son évaluation interne. Le gain venait du travail en parallèle, sur des questions qui se découpent bien.
La structure sert enfin la gouvernance. Chaque sous-tâche est documentée par son brief et son rapport : un responsable retrace après coup qui a produit quoi, sur quel modèle et à partir de quelles consignes. L’audit d’un travail délégué s’appuie sur ces pièces, étape par étape.
Qu’est-ce que la gamme Claude 5.5 change ?
| Modèle | Étage | Entrée | Sortie | Lecture de cache |
|---|---|---|---|---|
| Fable 5.1 | orchestration, synthèse | 10 $ | 50 $ | 0,25 $ |
| Opus 5.5 | relecture experte, jugement | 4 $ | 20 $ | 0,20 $ |
| Sonnet 5.5 | production en série | 2 $ | 10 $ | 0,10 $ |
| Haiku 5.5 | contrôles, extraction, résumés | 0,10 $ | 0,50 $ | 0,01 $ |
Prix API Anthropic par million de tokens au 8 octobre 2026. Fable 5.1 se place au-dessus de la gamme 5.5. Haiku 5.5 : prompts jusqu’à 100’000 tokens, cinq fois plus au-delà.
L’étage bas a changé de catégorie. Sur GDPval-AA, un test de tâches professionnelles réelles noté en points Elo, Haiku 5.5 marque 1620 points, contre 735 pour Haiku 4.5 et 1840 pour Sonnet 5.5. Son prix baisse de 90% pour les prompts jusqu’à 100’000 tokens. C’est aussi le premier Haiku dont on règle l’effort : le même modèle répond vite sur un tri et raisonne plus longtemps sur une vérification.
L’étage du milieu a rejoint le haut. Sonnet 5.5, sorti le 28 septembre, termine à deux points d’Opus 5.5 sur GDPval-AA et le dépasse en terminal (70,6% contre 66,4%), pour la moitié du prix, ce qui permet de descendre la production en série d’un étage.
L’orchestrateur relit moins cher. Un orchestrateur relit tout son contexte à chaque requête. Ce poste domine vite la facture d’un agent qui travaille longtemps. La lecture de cache coûte 2,5% du prix d’entrée sur Fable 5.1 et 5% sur Opus 5.5 et Sonnet 5.5, contre 10% sur les autres modèles, Haiku 5.5 compris.
Le siège d’orchestrateur a deux candidats. Anthropic présente Fable 5.1 comme son modèle le plus capable en disponibilité générale et le décrit dans ce rôle précis : planifier le travail, mobiliser les outils, se rétablir quand une étape échoue. Les neuf tests publiés à l’annonce d’Opus 5.5 donnent tous l’avantage à Fable 5.1. Opus 5.5 coûte 2,5 fois moins cher. Anthropic précise lui-même qu’à l’usage l’écart est plus resserré que ces scores le suggèrent. Le critère de choix est la mission. Fable 5.1 la mène quand elle court sur des heures et que le modèle doit se rattraper seul. Opus 5.5 prend le siège quand le budget prime.
Quels réglages font ou défont le montage ?
Le modèle se déclare pour chaque sous-agent. Dans Claude Code, un sous-agent sans modèle déclaré prend celui de la conversation principale. Un fork, qui copie la session en cours, prend toujours son modèle. Un orchestrateur réglé sur le haut de gamme entraîne alors tous ses sous-agents au même tarif. Le paramètre model se renseigne à chaque lancement.
Le contexte de l’étage bas reste court. Haiku 5.5 coûte cinq fois plus au-delà de 100’000 tokens de prompt. Le brief transmet au sous-agent le seul extrait utile. La fenêtre de contexte d’un sous-agent dépend d’ailleurs de son propre modèle.
La mesure précède l’industrialisation. Selon Anthropic, un système multi-agents consomme environ quinze fois plus de tokens qu’une conversation. La quantité de tokens explique à elle seule 80% des écarts de performance sur son test de recherche. Un lot pilote, avec un relevé de consommation par modèle, montre si le découpage paie avant le passage à l’échelle.
Quand garder un seul modèle ?
En 2025, Anthropic jugeait la délégation mal adaptée aux tâches où tous les agents doivent partager le même contexte ou dépendent fortement les unes des autres. La plupart des tâches de développement entraient dans ce cas, moins faciles à découper que la recherche. Avec Haiku 5.5, l’éditeur la propose désormais aussi sur le code, pour des sous-tâches au périmètre précis. Le critère reste le même : la délégation paie sur le travail qui se découpe, comme les traductions page par page, les recherches en parallèle, les contrôles en série ou l’extraction sur des lots de documents.
Questions fréquentes
Qu’est-ce qu’un sous-agent IA ? Un agent lancé par un autre agent pour une tâche précise. Il travaille dans sa propre fenêtre de contexte, avec ses outils et son modèle, puis rend un rapport à l’agent qui l’a lancé.
Quel modèle Claude choisir pour un sous-agent ? Haiku 5.5 pour les tâches étroites et répétées (tri, extraction, résumé, contrôle), Sonnet 5.5 pour la production en série, Opus 5.5 pour la relecture experte et les cas qui demandent du jugement. L’orchestrateur tourne sur le haut de gamme : Fable 5.1 pour les missions longues et autonomes, Opus 5.5 quand le budget prime.
La délégation coûte-t-elle toujours moins cher ? Le prix par token baisse, mais le volume monte : un système multi-agents consomme environ quinze fois plus de tokens qu’une conversation, d’où l’intérêt de mesurer l’économie sur un lot pilote.
Sources
- Anthropic, Introducing Claude Haiku 5.5, 7 octobre 2026.
- Anthropic, Pricing, consulté le 8 octobre 2026.
- Anthropic, Introducing Claude Sonnet 5.5, 28 septembre 2026.
- Anthropic, Introducing Claude Opus 5.5, 22 septembre 2026.
- Anthropic, Claude Fable 5.1, consulté le 8 octobre 2026.
- Anthropic, How we built our multi-agent research system, 13 juin 2025.
- Anthropic, Building effective agents, 19 décembre 2024.
- Claude Code, Subagents, consulté le 8 octobre 2026.
Un sujet à creuser pour votre entreprise ?
Échangeons 30 minutes pour comprendre votre contexte et identifier où l'IA peut vous servir.
Parler avec un de nos experts